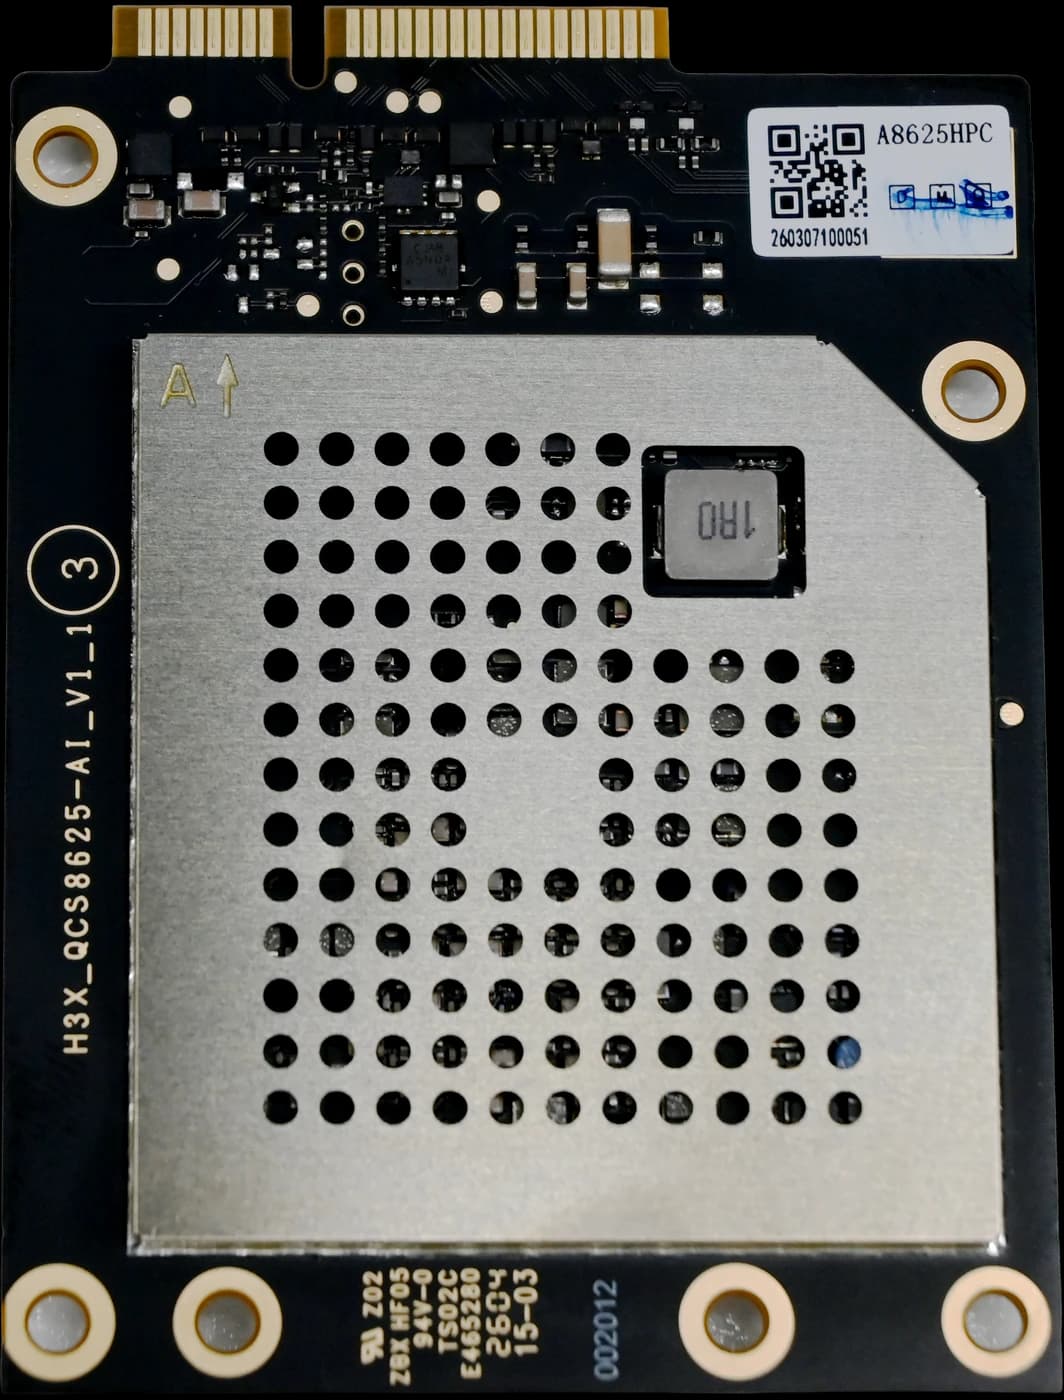
独立内存与系统存储
标准 12 GB LPDDR5X、128 GB UFS 3.1,可选 16 / 24 GB 内存,按模型部署需要确认配置。
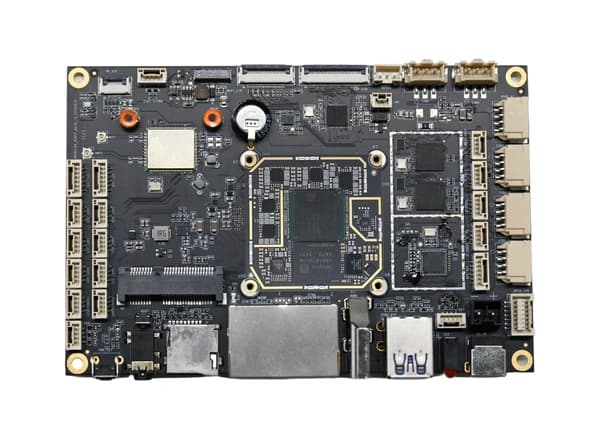
围绕模型、外设与终端形态,让计算平台适合你的设备任务。
标准 12 GB LPDDR5X、128 GB UFS 3.1,可选 16 / 24 GB 内存,按模型部署需要确认配置。
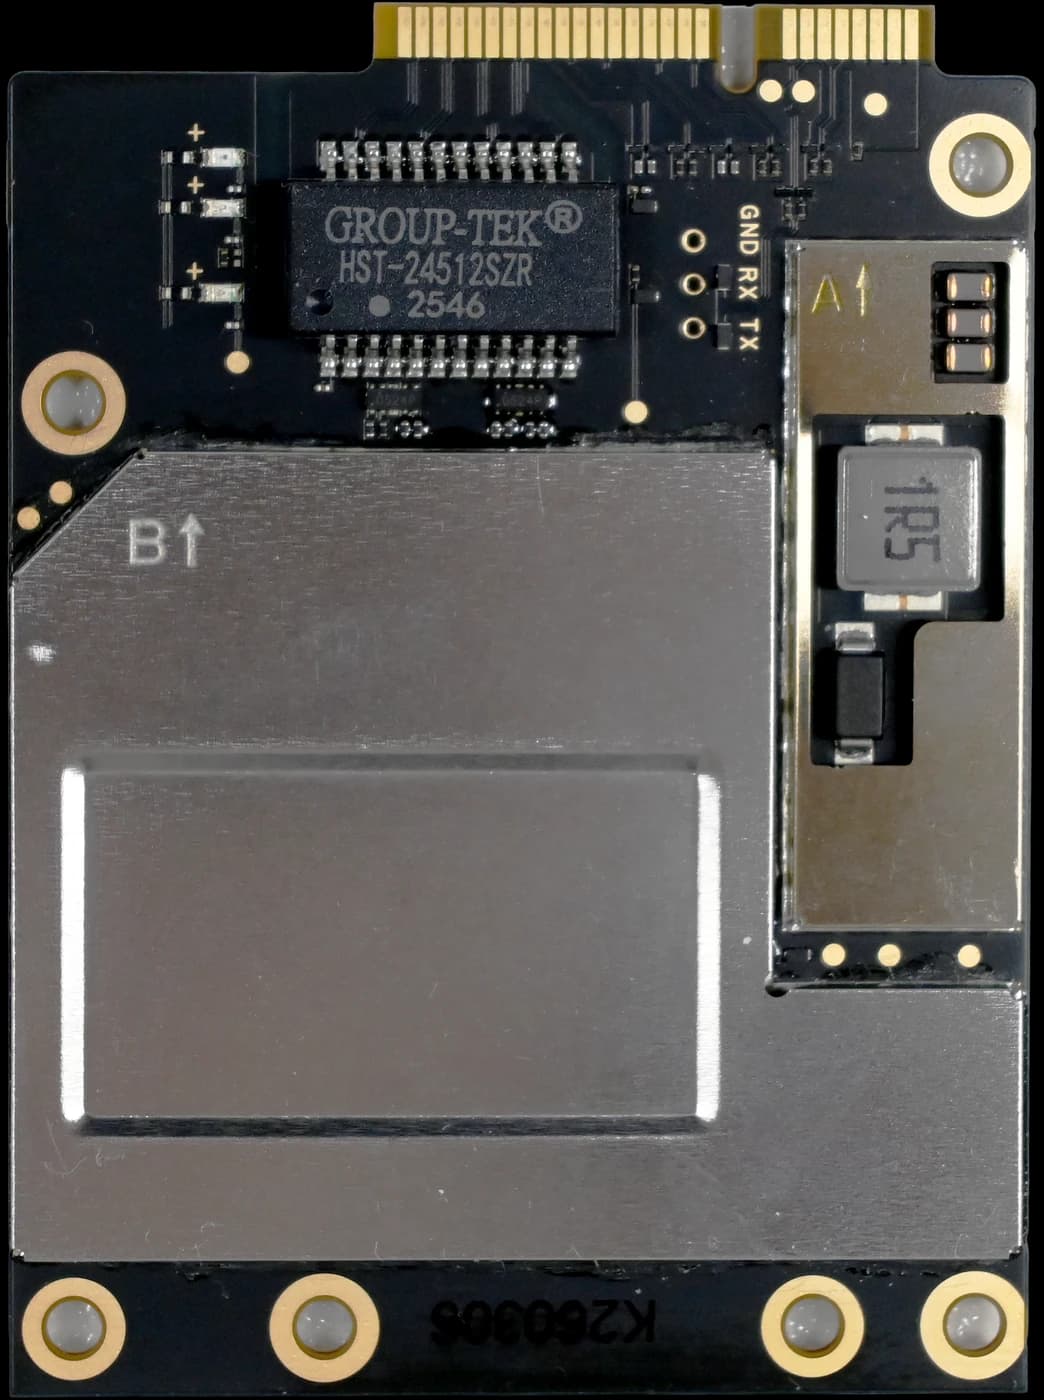
通过 PCIe、以太网与 USB 等接口,结合适配载板、驱动和通信服务连接主机与卡上运行环境。
CPU、Adreno 750、NPU 和视频单元,面向适配的视觉、语言与多模态应用。
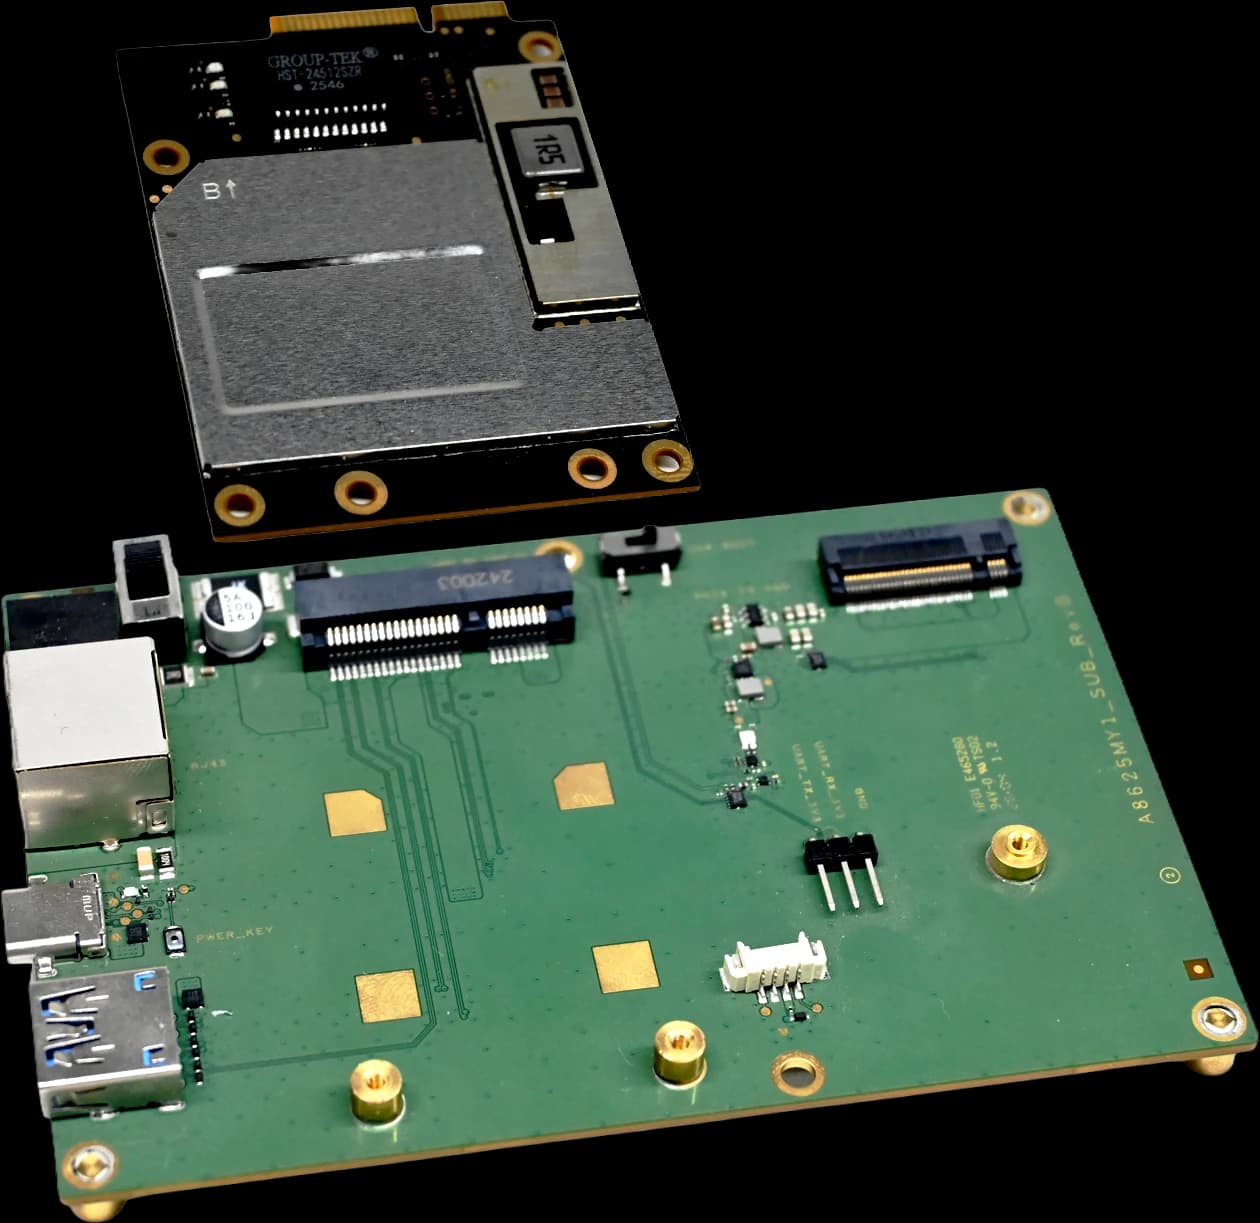
52-pin 金手指采用本产品定义,需核对电源、信号和散热,结合适配板开展整机集成。
按主机链路与连接定义,评估 AI 算力扩展。
功能分类示意;连接器位置与电气定义见产品规格书。
1 × PCIe 4.0 x2,经专用金手指引出
结合平台计算特点与本型号接口,选择适合的终端任务和集成路径。
Qualcomm QCS8625
围绕多路网络视频接入、存储与识别分析,构建本地运行的视频智能处理链路。
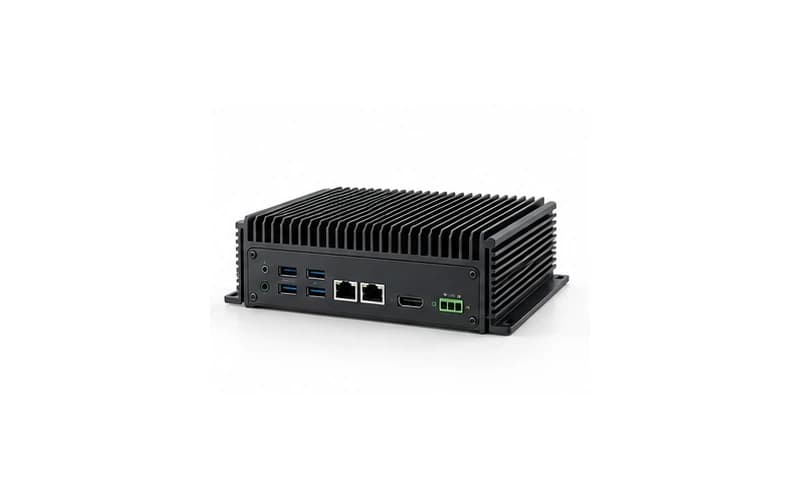
面向已有视频系统与主机扩展,将 AI 分析结果连接到告警、检索和业务应用。
终端形态为应用方向示意;外设、整机结构与软件按项目适配。
以下为端侧 AI 算力卡资料所列配置,模组接口能力与整机实际引出接口分别说明。
| 计算平台 | Qualcomm QCS8625 |
|---|---|
| 制程 | 4 nm |
| CPU | 八核 Qualcomm Kryo,最高 3.4 GHz |
| NPU | Qualcomm Hexagon |
| AI 算力(INT8,稠密) | 最高 60 TOPS(INT8,稠密) |
| AI 算力(INT8,稀疏) | 最高 120 TOPS(INT8,稀疏) |
| AI 算力(FP16) | 最高 15 TOPS(FP16) |
| GPU | Qualcomm Adreno |
| 标准内存 | 12 GB LPDDR5X |
| 可选内存 | 16 GB / 24 GB LPDDR5X,按订购配置 |
| 存储 | 128 GB UFS 3.1 |
| 视频解码 | 平台最高 4K240 / 8K60 |
|---|---|
| 视频编码 | 平台最高 4K120 / 8K30 |
| 模型部署 | LLM / VLM / VLA 按对应内存、量化、上下文与适配方案评估 |
| 运行系统 | Linux Embedded,配套模型工具与运行库 |
| PCIe | 1 × PCIe 4.0 x2,经专用金手指引出 |
|---|---|
| 以太网 | 板载 RTL8125B-CG 2.5GbE 控制器;RJ45 位于配套载板 |
| USB | 1 组 USB 3.1 + 1 组 USB 2.0 信号;物理插座由载板实现 |
| 调试 UART | 1 组,1.8 V TTL |
| I²C | 1 组,1.8 V |
| 连接 | 52-pin 金手指,专用引脚 / 供电定义 |
| 产品代码 | A8625MY1 |
|---|---|
| 外形 | 47 × 64 mm;PCB 板厚 1.00 mm |
| 电源 | 12 V DC,经金手指 VCC12 V_SYS 输入 |
| 功耗口径 | 资料 NPU 典型推理 7 W,仅指 NPU,非整卡功耗 |
| 散热 | 可选鳍片与 5 V 风扇;计入 CPU / GPU / 内存 / 网络等总负载 |
| 主机软件 | PCIe 驱动、协议服务与模型运行库需使用匹配版本 |
AI 算力为平台标称峰值。稠密、稀疏及 FP16 分别列示;实际性能取决于模型、精度、软件与散热。 输入电源规格不等同于整板功耗;配件与软件镜像按具体交付配置确认。
采用专用 52-pin 金手指连接定义,不代表兼容任意 Mini-PCIe 插槽。主机数据通道和电气连接需配套适配。
60 TOPS 为 INT8 稠密、120 TOPS 为 INT8 稀疏口径。NPU 典型推理功耗不能作为整卡功耗。
告诉我们你的模型、外设、结构空间与系统需求,一起确定产品和交付配置。